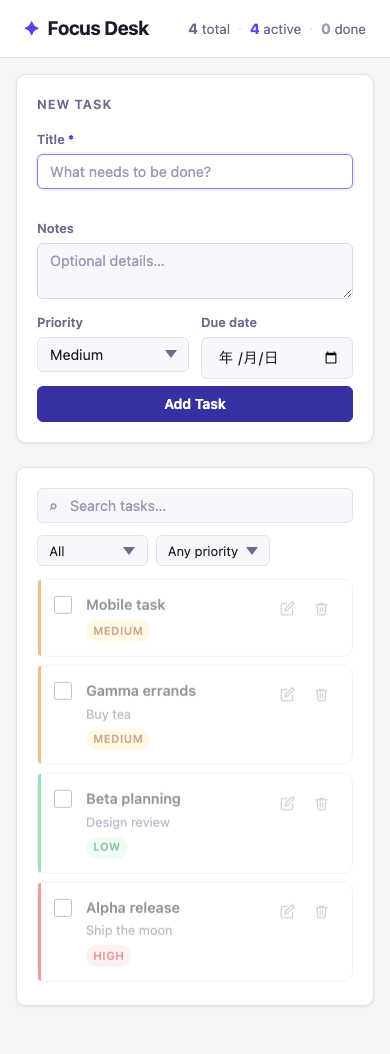
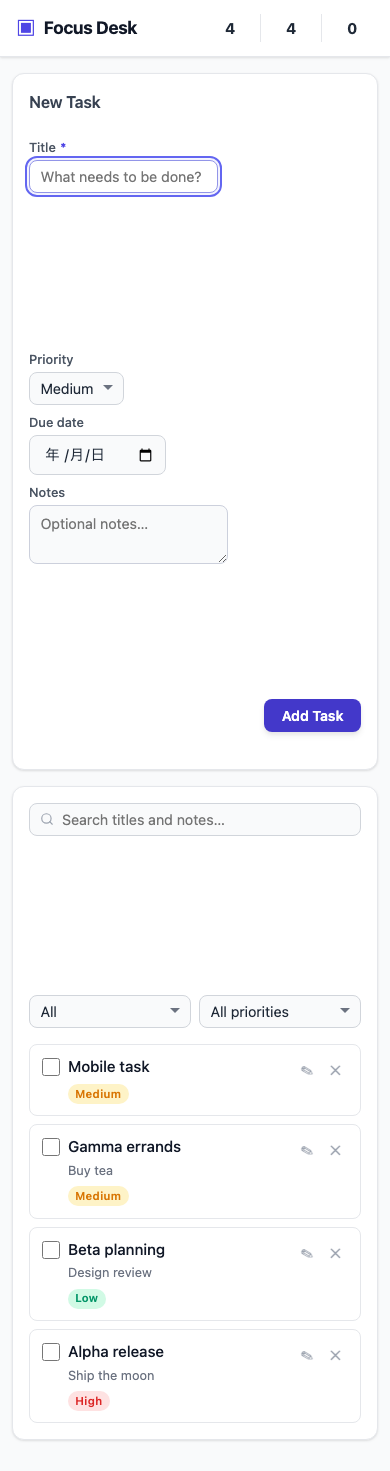
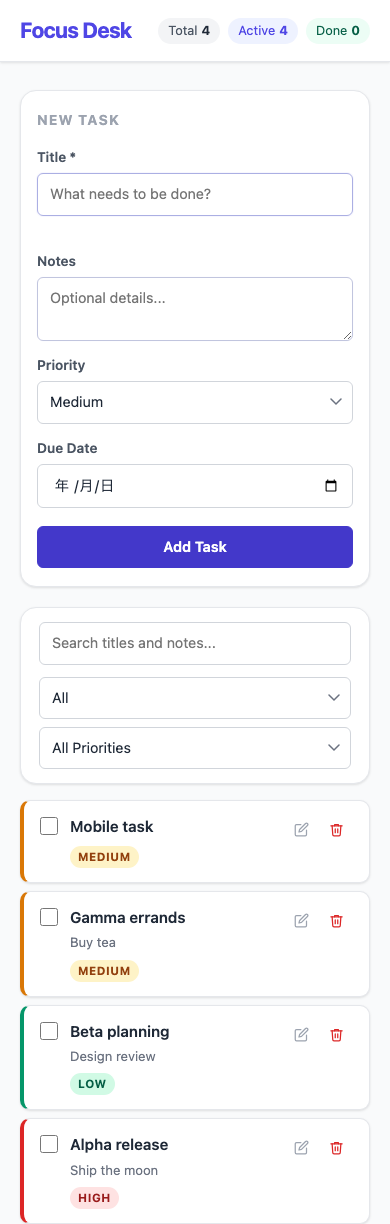
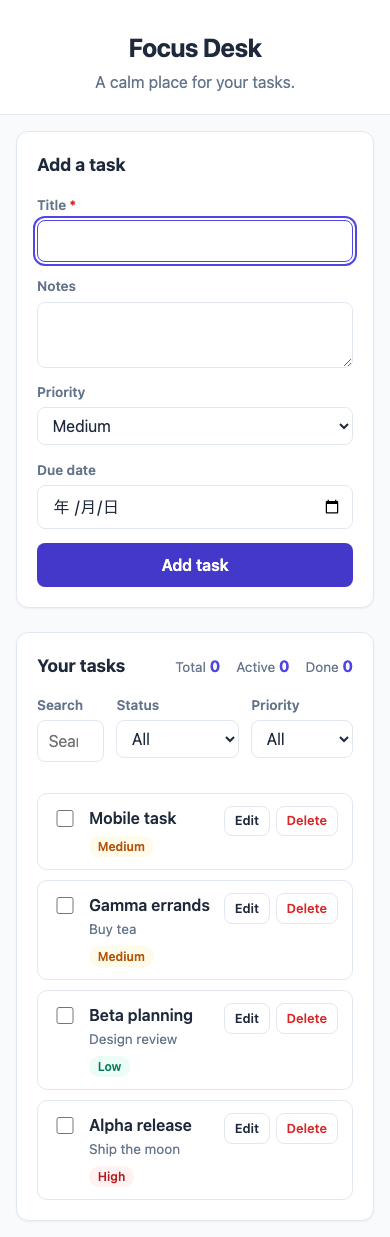
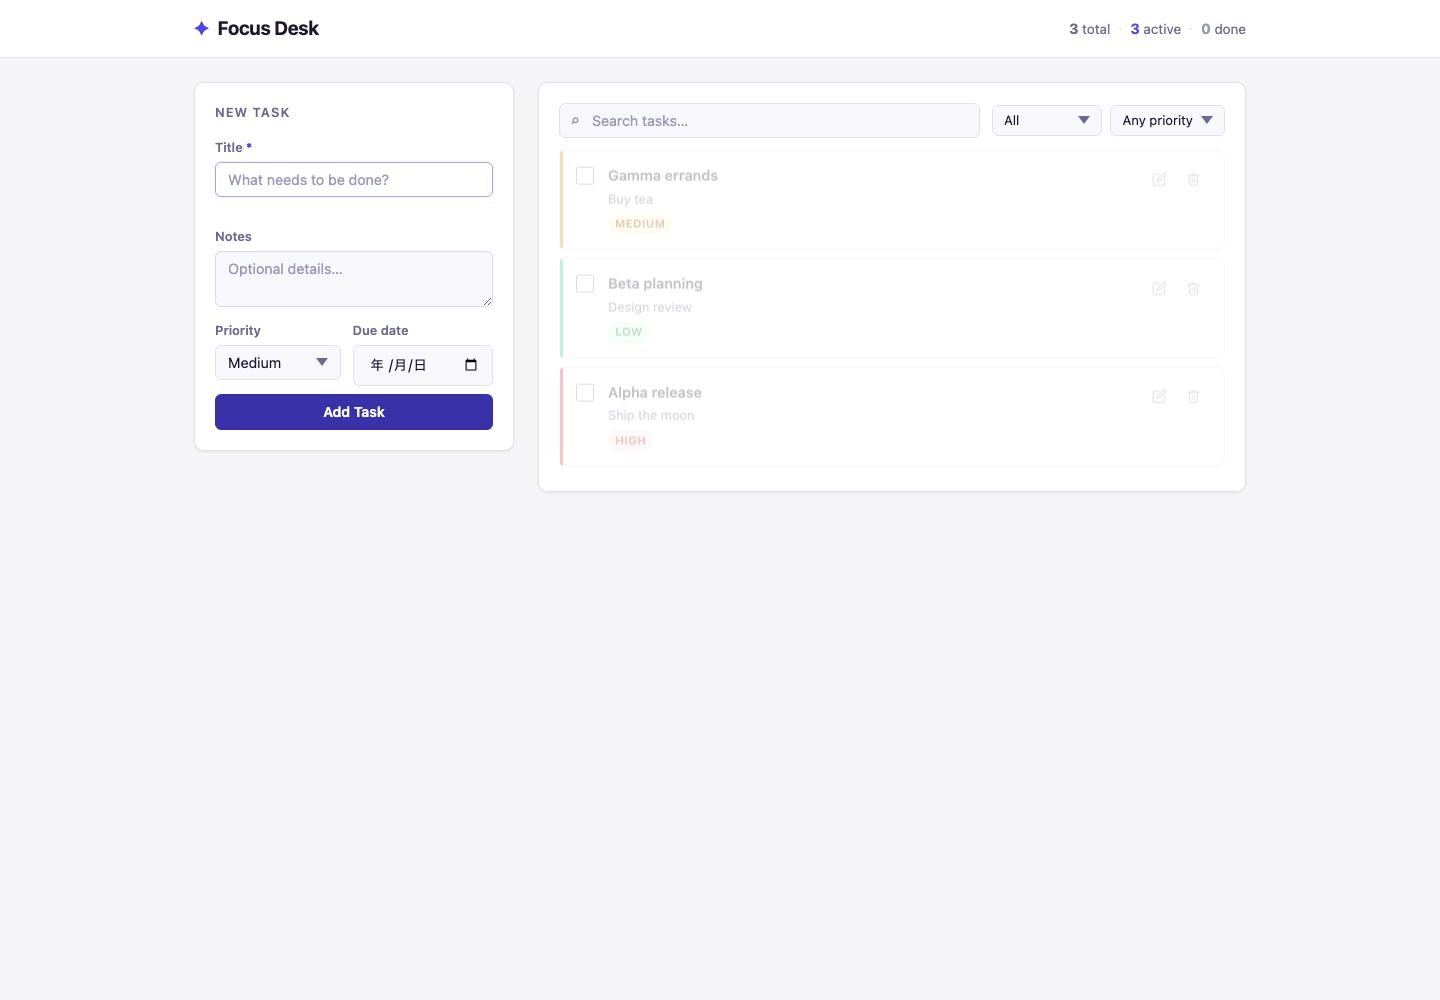
Claude Code + Sonnet 4.6
92.05円 / 254.36秒 / 20/20
費用予約枠で停止
モデルを簡単に選び替えられる。その小さな便利さが、開発の費用を大きく変えることがある。
SenteでGLM-5.2を使い、タスク管理Webアプリを作ってみた。実行開始から39.35秒で正常終了。推定利用料は2.14円。生成後に別途ブラウザで検証すると、共通20項目すべてに合格した。
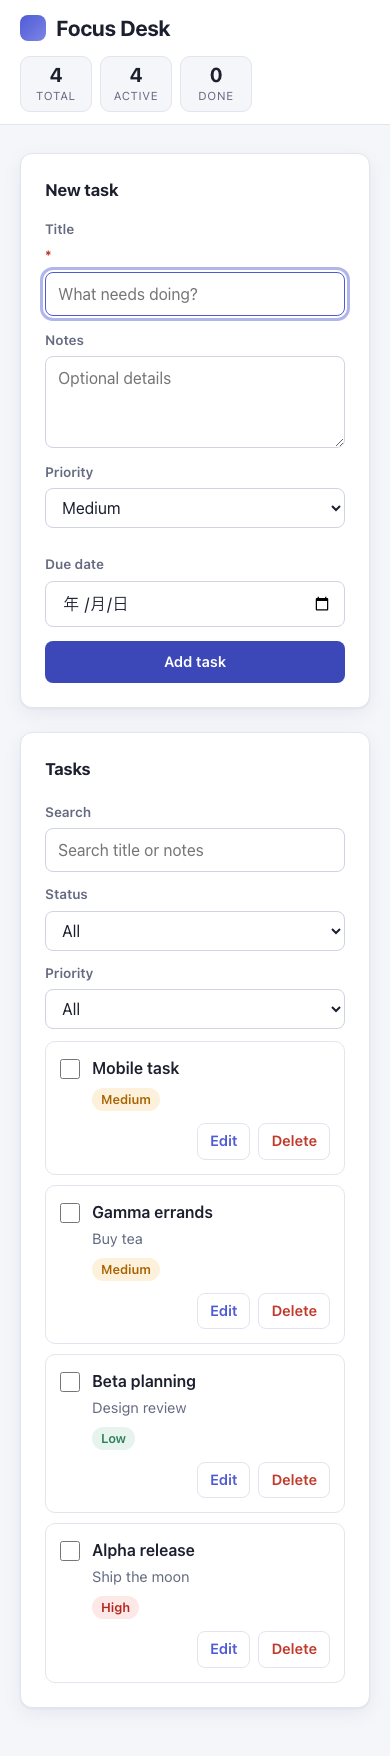
検索、絞り込み、編集、削除、保存。スマホ幅でも使える。画面の見本を出しただけではなく、操作できるアプリができていた。[1]
今回おもしろかったのは、Senteのままモデルを選び替えて、費用と成果物を見比べられたことだ。
使い慣れた道具はそのままに、仕事に合うAIを選ぶ。 その意味が、約2円の成果物として見えた。先に試したHY4も約16円で20項目に合格している。
本記事はSente開発側による2026年9月14日の実験記録です。各条件は1試行。正常終了と途中停止を分けて記載し、録画・生成物・検証ログを添えています。記載の費用は共通API経由のusageから算出した推定額で、各社の月額プラン料金や最終請求額の比較ではありません。
課題は「Focus Desk」という小さなタスク管理Webアプリ。HTML・CSS・JavaScriptで作り、外部ライブラリや有料サービスに頼らない条件にした。
第2試行以降は、ソースを24KB未満に収める条件も加えた。生成物への手直しはせず、別のブラウザテストで採点した。[1][2]
「作りました」という返答ではなく、実際に追加できるか。編集できるか。再読み込みしても残るかを見る比較だ。
最初にClaude Sonnet 4.6を使って3製品を比較し、その後SenteでGLM-5.3 FlashとHY4 Previewを同時実行した。さらにGLM-5.2を単独実行し、Kimi K3・Fable 5.1・Haiku 4.5・Opus 5を同時実行した。
| 製品・モデル | 試行の推定費用 | 開始から終了・停止まで | 終了状態 | 共通検証 |
|---|---|---|---|---|
| Claude Code+Sonnet 4.6 | 92.05円 | 4分14秒 | 実験側の費用予約制限 | 20/20 |
| Sente+Sonnet 4.6 | 72.12円 | 3分56秒 | APIエラー | 20/20 |
| OpenCode+Sonnet 4.6 | 89.67円 | 4分55秒 | 実験側の費用予約制限 | 20/20 |
| Sente+GLM-5.3 Flash | 0.15円+未確定分 | 3分16秒 | APIエラー・未完成 | 3/20 |
| Sente+HY4 Preview | 16.27円 | 4分40秒 | 正常終了 | 20/20 |
| Sente+GLM-5.2 | 2.14円 | 39秒 | 正常終了 | 20/20 |
| Sente+Kimi K3 | 17.60円 | 42秒 | 正常終了・動作不良あり | 17/20 |
| Sente+Fable 5.1 | 108.40円 | 2分6秒 | 実験側の費用予約制限 | 20/20 |
| Sente+Haiku 4.5 | 26.66円 | 2分22秒 | 正常終了・構文エラーあり | 3/20 |
| Sente+Opus 5 | 173.11円 | 6分48秒 | 正常終了 | 20/20 |
出典:集計JSON。時間は丸めている。
この表の時間を、そのまま速さの順位にしてはいけない。 途中で止まったものと、最後まで走ったものが混ざっているからだ。検証も停止後に実行しており、「初めて全項目に合格した時刻」は測っていない。
それでも、明確な収穫がある。Sente+GLM-5.2は39秒、HY4は4分40秒で正常終了し、どちらのアプリも20項目を通過した。推定費用はそれぞれ約2円、約16円だった。
追加の4モデルでは、Opusも正常終了・20/20だった。一方、Kimi K3とHaikuはCLIが正常終了しても、成果物には不具合が残った。「処理が終わった」と「アプリが動く」は別だ。Fableも成果物は20/20だが、最後まで走り切ってはいない。追加5モデルの詳細
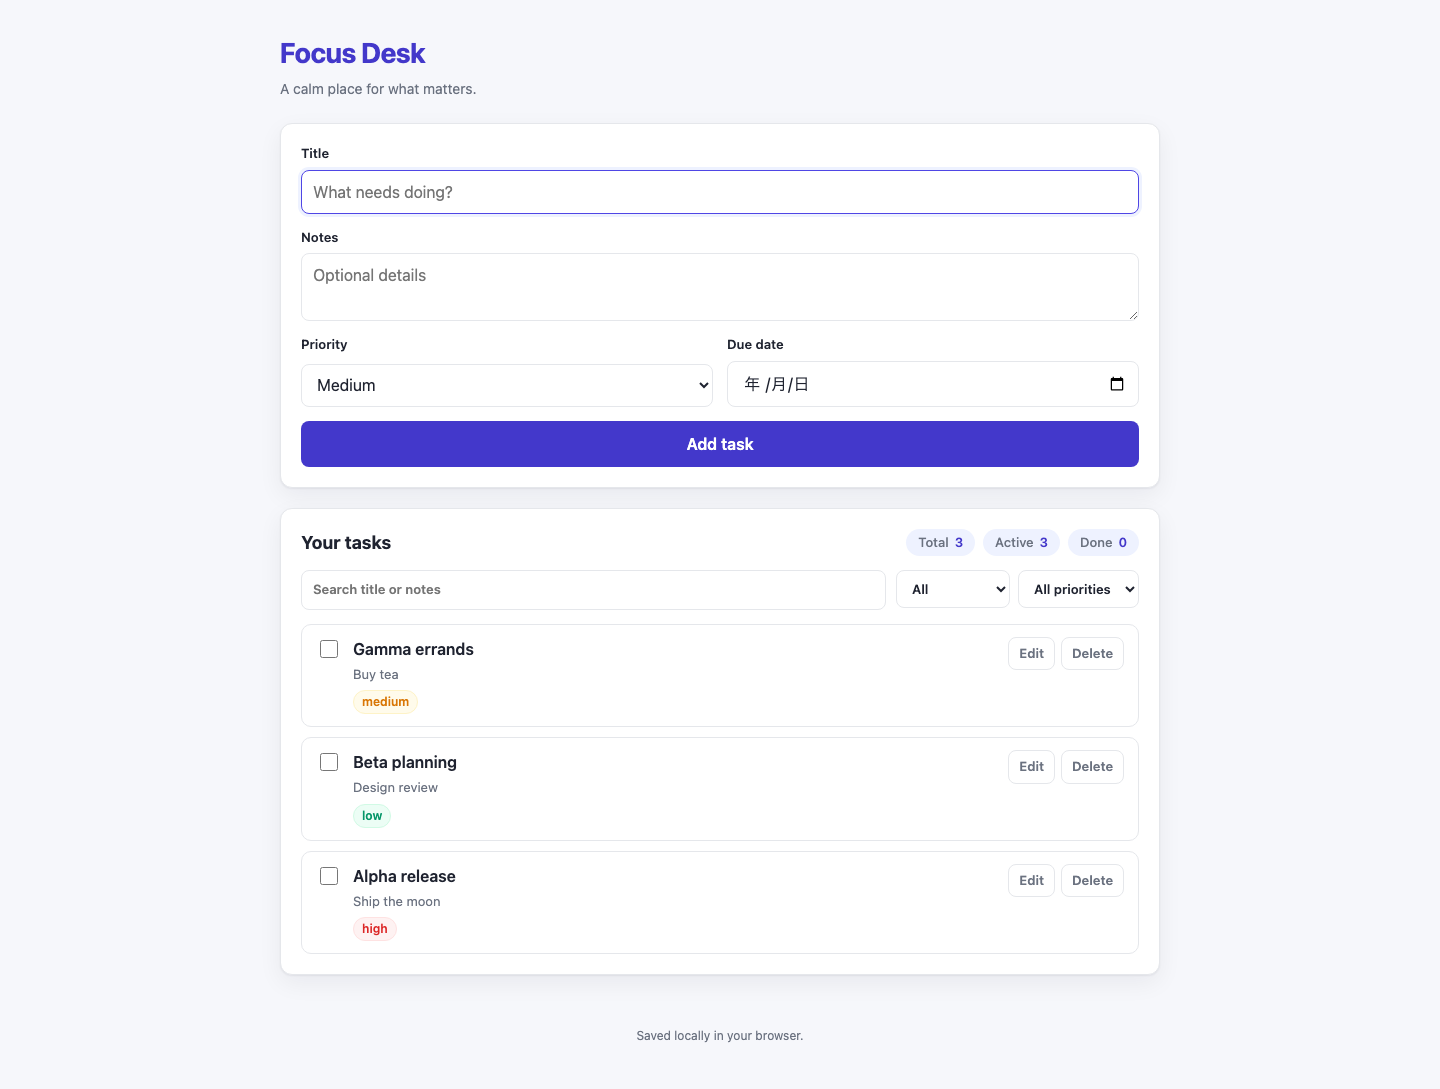
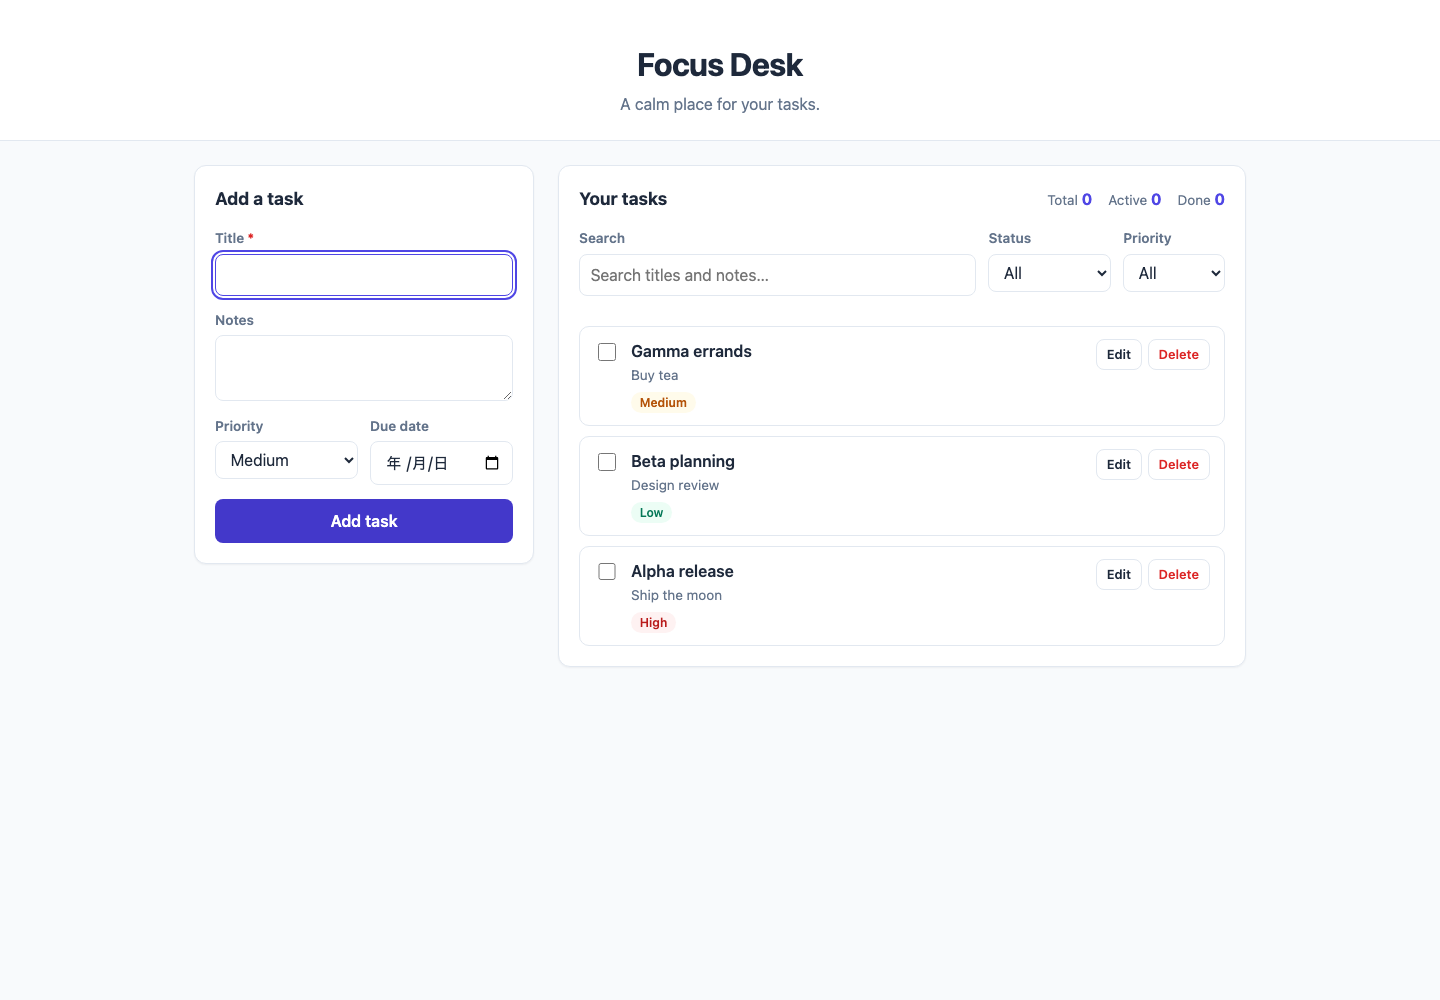
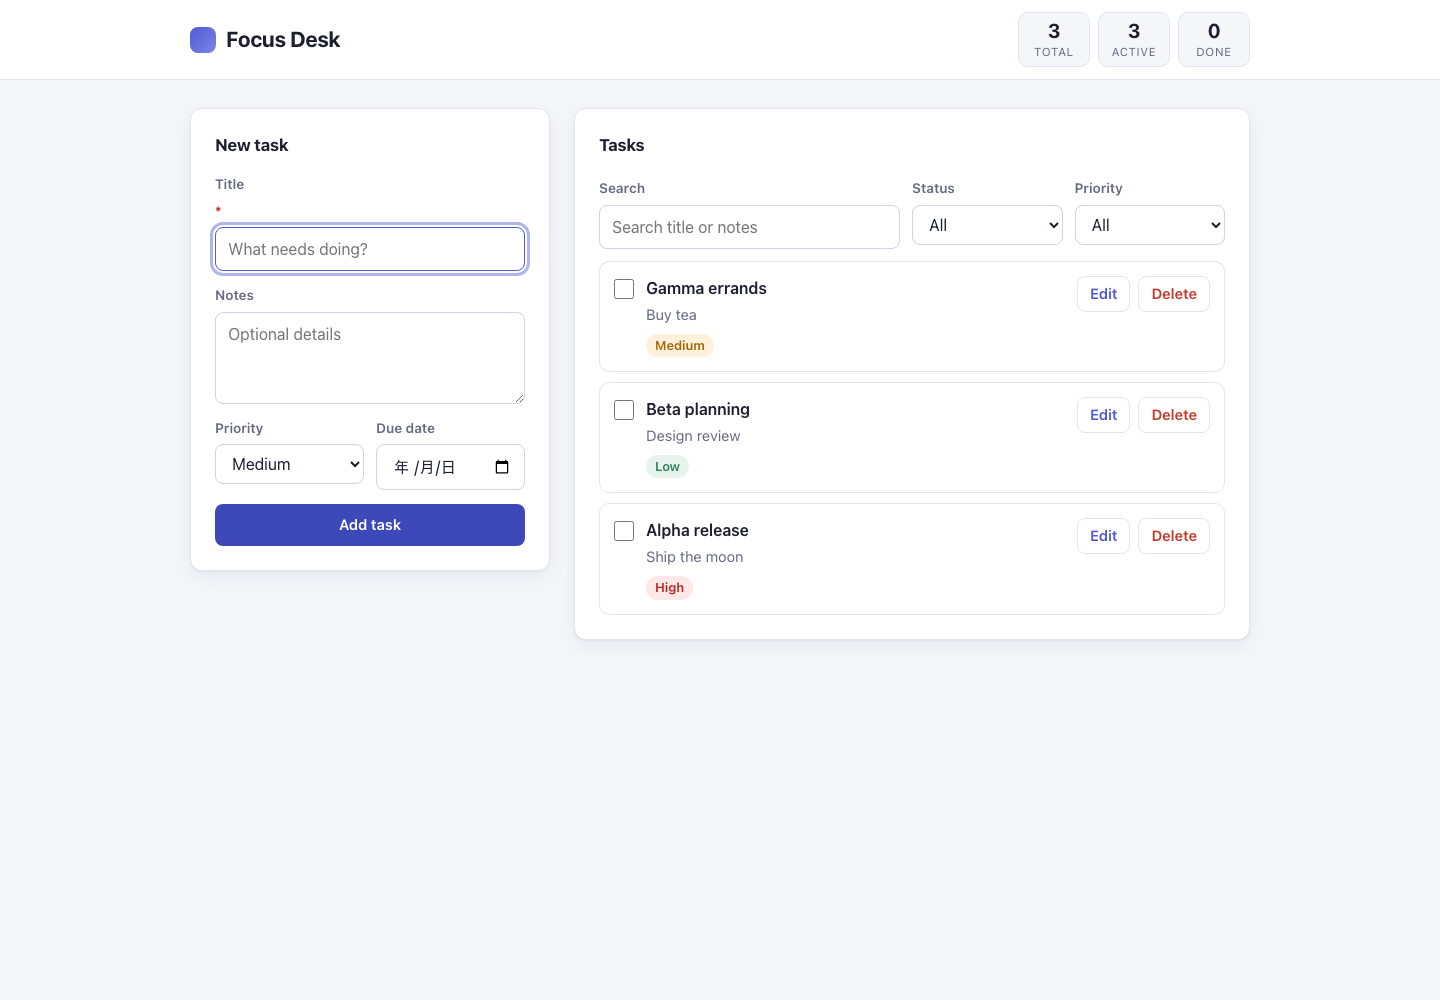
GLM-5.2はAPIを7回呼び出し、17,531 bytesのHTML・CSS・JavaScriptを生成した。タスクの追加・タイトル編集・削除・完了切替、検索と複合フィルタ、再読み込み後の保存を実際に操作して確認。壊れた保存JSONへの対応、入力HTMLの安全性、PC・スマホ幅の検証も通った。
この20項目の範囲では、約2円の試行でも動く成果物が得られた。細かなデザインの磨き込みや本番品質まで保証する点数ではないが、最初の試作品をつくる選択肢として印象的だった。検証原本
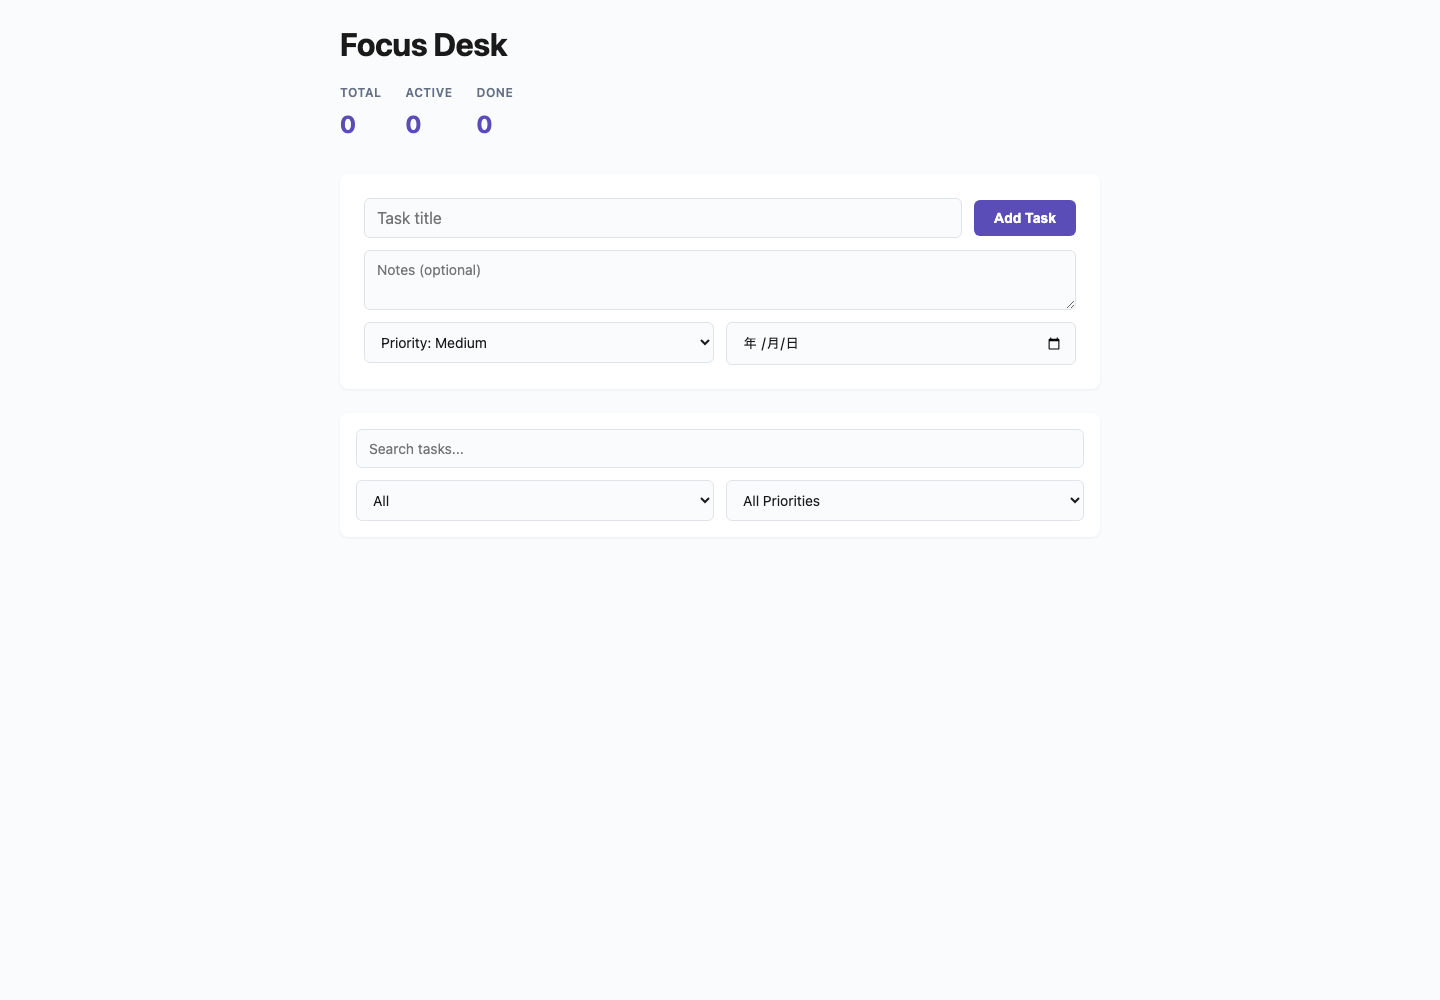
Kimi K3は17/20。件数表示を更新するJSが getElementById を使っているのに、対応HTMLには data-testid だけがあり、id がなかった。存在しない要素の textContent 更新で例外になっていた。壊れたJSONのテストで出た例外も、この表示処理に関係する。タスク追加・検索などは動くが、件数表示が壊れる成果物だった。JS 7行・95–97行 / HTML 49–52行
Haikuは3/20。div.data-testid = 'task-item'; という記述がJavaScriptの構文エラーになり、アプリの処理が起動しなかった。ブラウザのエラーだけでなく、node --check でも108行で再現した。ファイルを生成して正常終了しても、これだけで「使える」とは言えない。JS 108行 / 検証原本
これらの生成物は、比較のため親側で機能修正せず保存している。
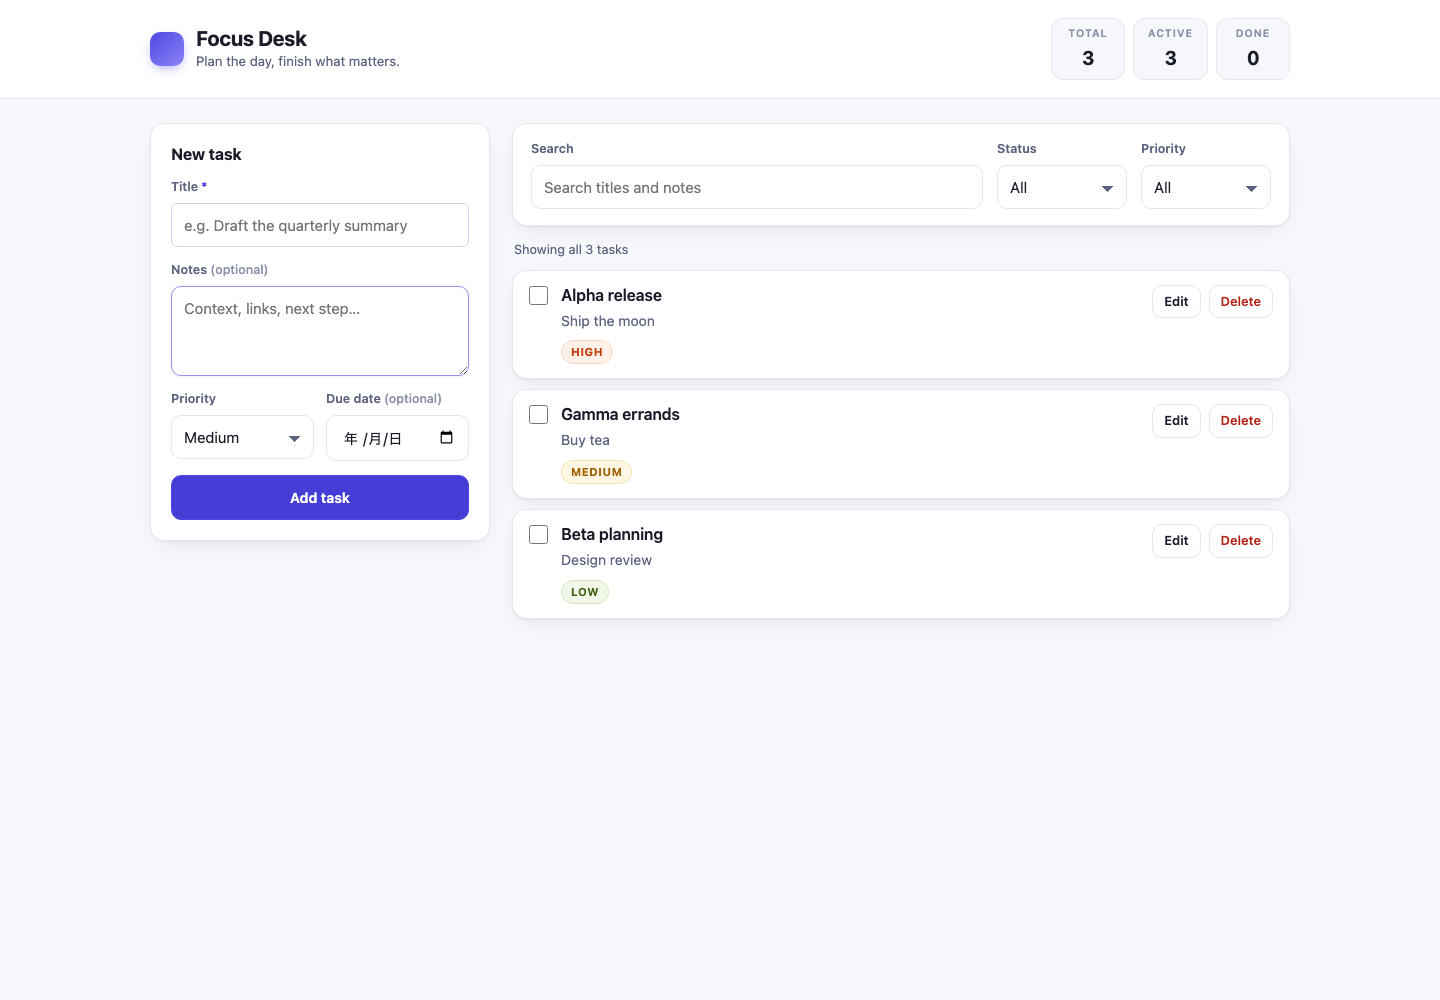
Fableは19,912 bytes、Opusは23,647 bytes。両方とも20項目に合格した。Fableは次の応答に必要な保守的な費用予約が入らず126秒で停止。108.40円は実費推定であり、約533円の上限を使い切ったという意味ではない。Opusは408秒で正常終了した。Fable検証 / Opus検証
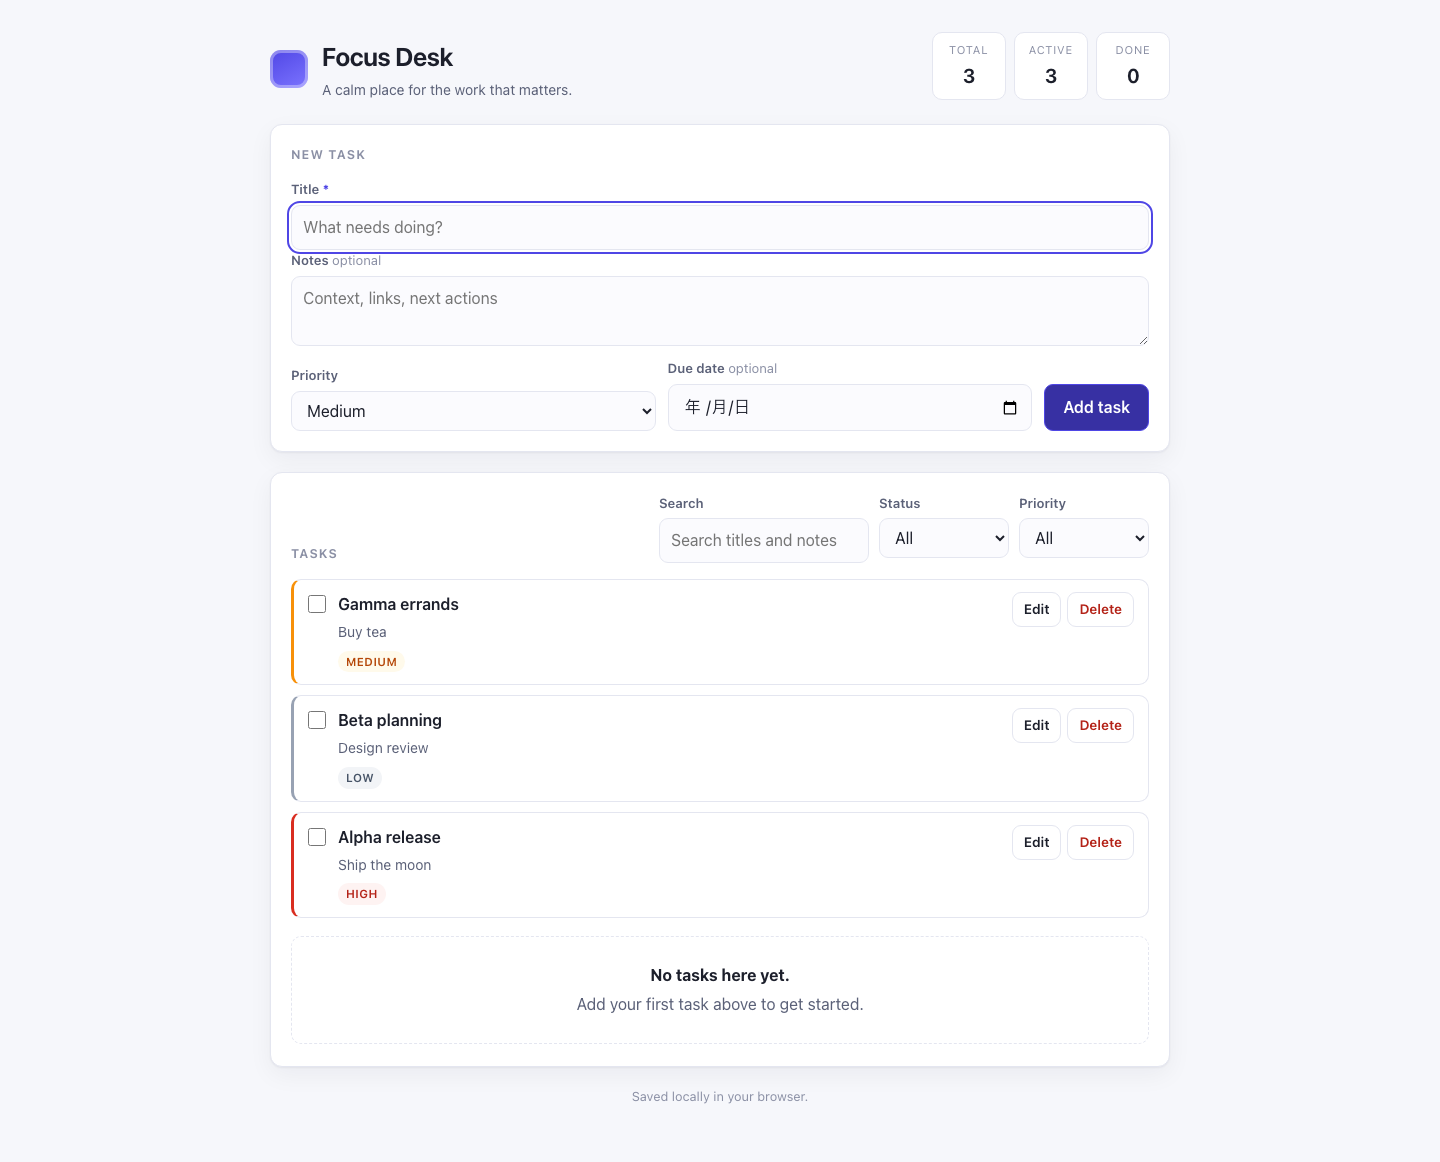
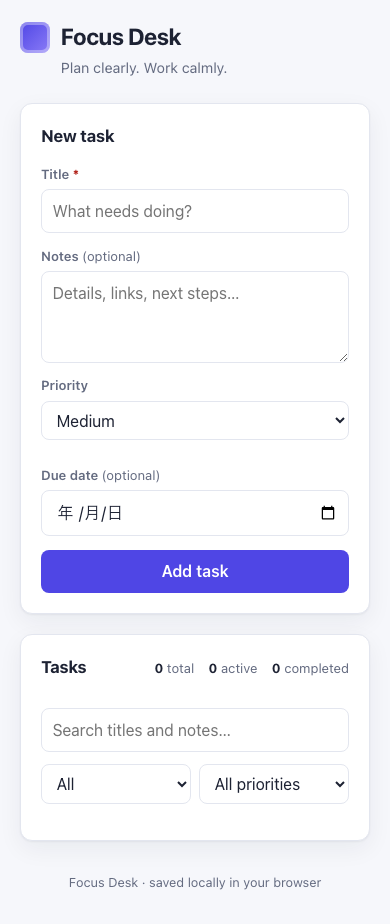
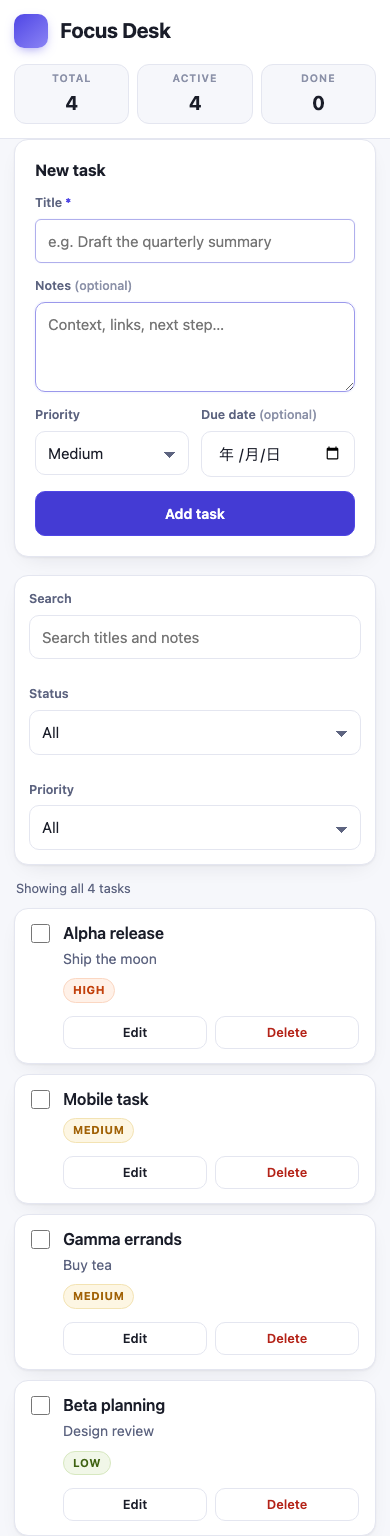
HY4の成果物は、タスク一覧の中に編集フォームを出すインライン編集方式だった。タイトルだけでなく、メモ・優先度・期限も変更できる。追加検証では、それらの変更が再読み込み後も残ることを確認した。[3]
HTML・CSS・JavaScriptの合計は20,621 bytes。24KB未満の条件も満たしている。
保存データを読み込む際には、タイトルや優先度などを正規化している。日付表示はブラウザのロケールを利用する。小さいながらも、表示して終わりではない実装だった。[4]
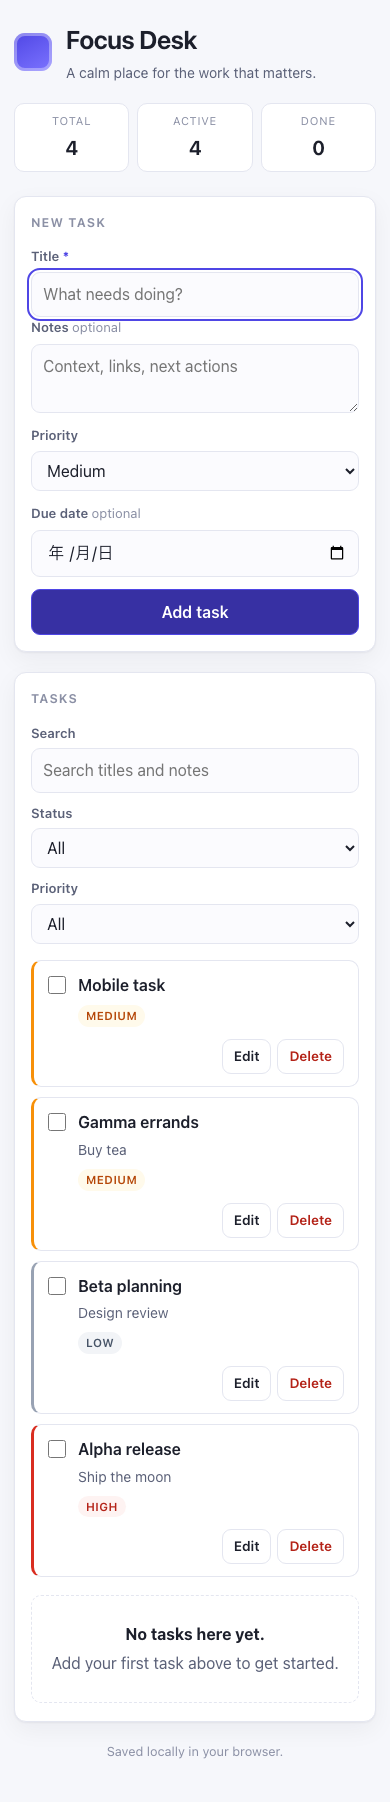
ただし、本番投入まで完璧という意味ではない。保存先が使えない場合、保存失敗をお客様に知らせず処理を続ける箇所がある。通常の保存テストには合格しているが、この例外時の扱いは改善余地だ。[4]
| 成果物 | コード・検証で確認できた特徴 | ソースサイズ |
|---|---|---|
| Claude Code+Sonnet | 「まだタスクがない」と「検索条件に一致しない」で案内文を変える | 22,971 bytes |
| Sente+Sonnet | 編集・削除ボタンの読み上げ名にタスク名が入り、対象を区別しやすい | 25,898 bytes |
| OpenCode+Sonnet | Sonnet3成果物の中で最小。ただし圧縮されたコードは読みやすさとの引き換え | 19,085 bytes |
| Sente+HY4 | インライン編集。保存データの正規化。ブラウザのロケールに沿った日付表示 | 20,621 bytes |
Sente+Sonnetだけは、24KB未満という追加条件を満たしていない。Sonnetを使った3成果物には、編集モーダル内にTab移動を留める処理や、閉じた後に元のボタンへフォーカスを戻す処理がなかった。[2][5]
20/20は、今回の基本機能が動いたという意味。すべての品質が同点という意味ではない。 見た目の主観的な順位は付けず、10条件の画面と成果物を並べて確認できるようにした。
Sente+Sonnetの試行費用は72.12円。Sente+HY4は16.27円だった。
今回の記録上、HY4側は約77.4%低い費用になった。ただし、Sonnet側は途中停止しており、両者の出力枠にも差がある。これは「Senteがいつでも77%安い」という主張ではなく、今回の2試行の費用差だ。
内訳を見ると、何が効いたかがわかる。
| Senteで使ったモデル | 入力tokens | 出力tokens | 入力分の推定費用 | 出力分の推定費用 | 合計 |
|---|---|---|---|---|---|
| Sonnet 4.6 | 89,418 | 14,826 | 39.43円 | 32.69円 | 72.12円 |
| HY4 Preview | 83,601 | 16,381 | 10.25円 | 6.02円 | 16.27円 |
HY4は出力tokensを減らして安くしたわけではない。むしろ今回の出力はSonnetより多い。 API呼び出しもSonnetの24回に対してHY4は23回。短い返答を一度出して終わった結果ではない。[1]
差を大きくしたのはモデル単価だ。
| 実行時の単価 | 入力1,000tokens | 出力1,000tokens |
|---|---|---|
| Sonnet 4.6 | 約0.441円 | 約2.205円 |
| HY4 Preview | 約0.123円 | 約0.368円 |
| GLM-5.3 Flash | 約0.011円 | 約0.039円 |
参考として、HY4試行と同じtokens数にSonnetの単価を掛けると約72.99円になる。これは仮の単価計算であり、Sonnetを再実行した結果ではない。しかし、モデル選択が費用にどう効くかを説明してくれる。[6]
Senteの価値は、この選択を普段の作業の中で行いやすくすることにある。
GLM-5.2の実測は入力22,839tokens、出力6,756tokens。入力分約1.11円と出力分約1.03円で、合計約2.14円だった。入力1,000tokensあたり約0.0485円、出力は約0.1523円。HY4より低い単価に加え、API呼び出しが7回で、今回の入力・出力量も少なかった。
これは単に返答を短くしただけの結果ではない。17,531 bytesの成果物を生成し、共通の動作テストを通過している。ただし、モデル内の処理や各提供元の内部ルーティングまで確認した数字ではなく、今回のAPI返却usageに基づく分析だ。GLM-5.2単価 / 実行ログ
今回、正常終了を確認できたHY4の時間は279.6秒。約4分40秒だ。これとは別に、生成後のブラウザ検証を行っている。
他の試行の停止時刻から「Senteは何%高速」「HY4が最速」とは言えない。特にClaude CodeとOpenCodeの停止は、こちらが用意した費用管理用プロキシによるものだ。各製品の性能限界を測った結果ではない。
API呼び出し回数を見ても、単純な話ではなかった。
| 条件 | API呼び出し回数 |
|---|---|
| Claude Code+Sonnet | 16 |
| Sente+Sonnet | 24 |
| OpenCode+Sonnet | 22 |
| Sente+HY4 | 23 |
呼び出しが少ないほど、必ず安い・速いというわけではない。1回に送る文脈の量、生成量、ツール実行、単価が違う。HY4のログにもツールエラーがあり、一直線に完成したわけではなかった。[1][7]
今回の速度について、正確に言えるのはここまでだ。
Sente+HY4は、約4分40秒の実行で正常終了し、その成果物が後続の20項目テストに合格した。
安さだけでなく、待てる時間で動くものができた。この組み合わせに手応えがある。
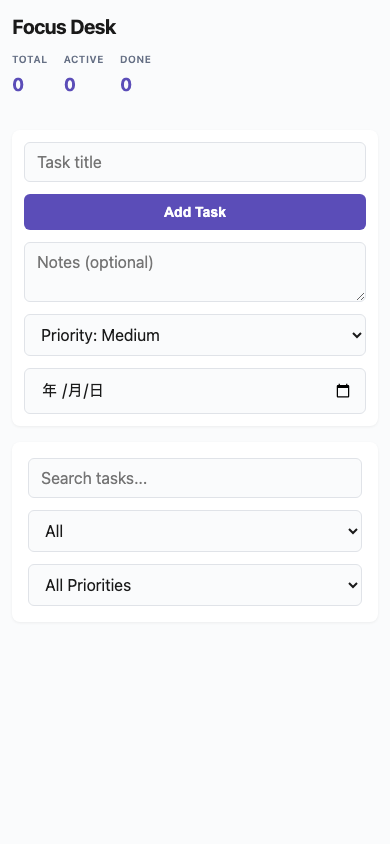
GLM-5.3 FlashはHTMLとCSSを書いた後、APIエラーで停止した。JavaScriptとREADMEは残らず、検証は3/20だった。
0.15円という数字は、費用が判明した分だけ。未確定の1リクエストがある。予約額を含めた安全側の計上では約2.34円になる。[1][6]
これは完成したアプリの単価ではない。3件の合格も、未完成の画面で通る静的な項目を含む。
また、APIエラーから「GLMにはこの課題が解けない」とも判断できない。今回の経路で、この試行が完了しなかったという結果だ。
単価を見る。使ってみる。成果物を確かめる。合わなければ選び直す。 この往復をしやすいことが、モデルを選べる道具の価値だと思う。
Senteのランチャーには、モデル一覧を表示する te models と、既定モデルを設定する te model がある。[8]
# 利用できるモデルを確認する
te models

# HY4を既定モデルにする
te model tencent/hy4-preview

# Senteを起動する
te
別のモデルを試すなら、選択を変える。
te model z-ai/glm-5.2
te
te model は以後の起動に使う既定設定を変更する操作で、実行中のセッションを切り替える操作とは異なる。明示的なモデル指定や設定の優先順位がある点にも注意したい。
重要なのは、モデルのたびに別の作業道具へ引っ越す必要がないことだ。同じSenteから、費用と得意分野の違うモデルを試せる。
今回のベンチマーク自体は、条件を固定するために隔離した設定とモデル指定で起動した。上のコマンド操作の所要時間を測った実験ではない。
te stats
te stats には、残高・今日と直近30日の利用・モデル別内訳を表示する実装がある。円換算はプラン別レートに対応し、JSONで取り出すこともできる。[9]
「このモデルは安いらしい」で終わらず、実際にどれだけ使ったかを確認する。その導線が同じCLIにある。
なお、今回の16.27円は te stats の画面から抜いた請求額ではなく、実験ログのusageと単価から算出した数字だ。
Senteには te talk の声モードへの導線と、KOEに登録した声を使う te voice 系の操作がある。声のオン・オフや登録案内もCLIにまとまっている。[10]
コーディングの相談を文字で続けるときも、声で依頼したいときも、入口を揃える。その使いやすさは、単純なtokens単価には表れない。
音声の速度・精度・追加費用は今回のコーディング比較では測っていない。ここは実装を確認した機能紹介だ。
Senteのランチャーには、インストール済みのClaude Codeをteai経由で起動する te claude、声モードなどで使うエンジンを選ぶ te engine、LiteLLMのゲートウェイに接続する te litellm がある。[11]
自分の使い方に合わせて、モデルだけでなく接続先や入口も選べる設計だ。各エンジンのインストール・認証、ゲートウェイの準備は別途必要になる。
ここでいうSenteらしさは、モデル選択・費用確認・声での依頼・接続の導線が、一つの道具にまとまっていることだ。
モデル切替そのものをSenteの独占機能とは言わない。OpenCodeの公式ドキュメントにも、複数プロバイダとモデル切替が明記されている。Claude Codeにもモデル設定とゲートウェイ接続の仕組みがある。[12]
今回、HY4を他の2製品で実行していないため、「約16円で作れるのはSenteだけ」とも言えない。Senteからその選択肢を使い、実際に動く成果物を得られたことが、今回示せた価値だ。
今回の記録で印象に残った数字は、最初は16.27円、追加実験では2.14円だった。
HY4もGLM-5.2も正常終了し、出来上がったアプリは別途行ったブラウザ検証で20項目を通過した。高いモデルでも停止や不具合は起こり、安いモデルでも今回の課題を通せる場合があった。
どの仕事もGLM-5.2やHY4で十分だとは思わない。大きなコードベースや難しい設計判断では、別のモデルを選びたくなるだろう。それも含めて、選び替えを簡単にしておく意味がある。
作業環境を変えずに、仕事に合うAIを選べる。試して、費用を見て、成果物で判断できる。
Senteでつくりたい便利さは、そこにある。
Senteの使い方を見る / 成果物ギャラリー / GLM・HY4の同時録画 / 3製品の同時録画
0.0.0-headless-model-fallback-202609131332、OpenCode 1.18.30。run-meta.json・verification.json。元の比較報告。te:3308–3311行(一覧)、3430–3455行(既定モデル設定)。機能の根拠メモ。te stats)。te talk案内)。今回の音声実走は未実施。te claude)、106–178行(LiteLLM設定・接続)。今回の横断的な実走は未実施。スクリーンショットは生成物のブラウザ表示。ソースは閲覧用テキストとして配信しています。
92.05円 / 254.36秒 / 20/20
費用予約枠で停止
72.12円 / 236.02秒 / 20/20
API生成エラー
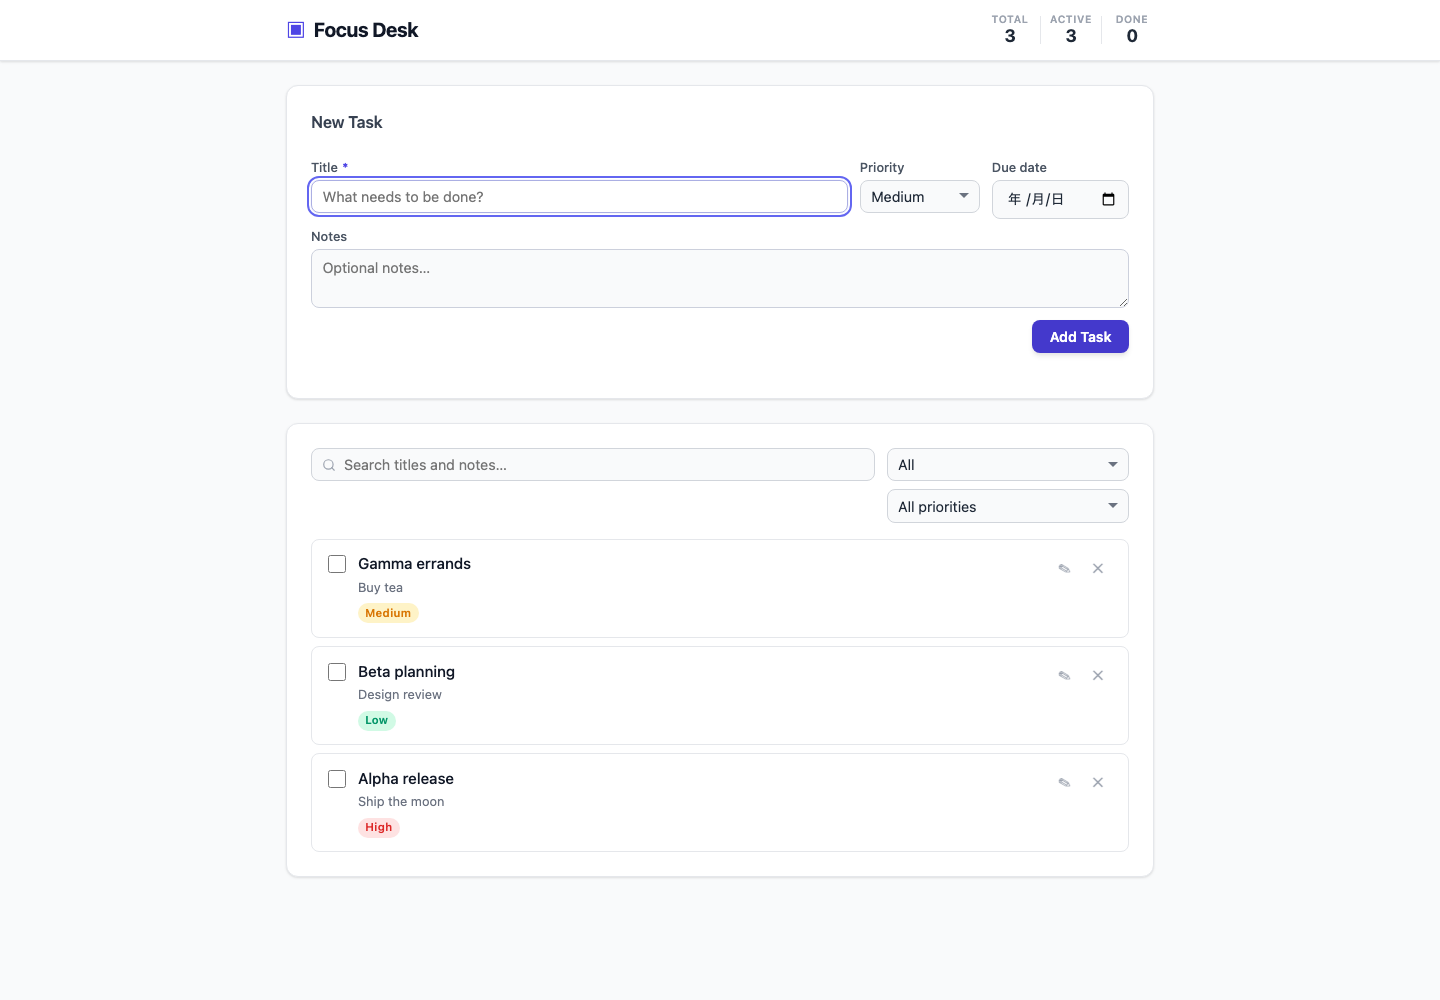
89.67円 / 295.26秒 / 20/20
費用予約枠で停止
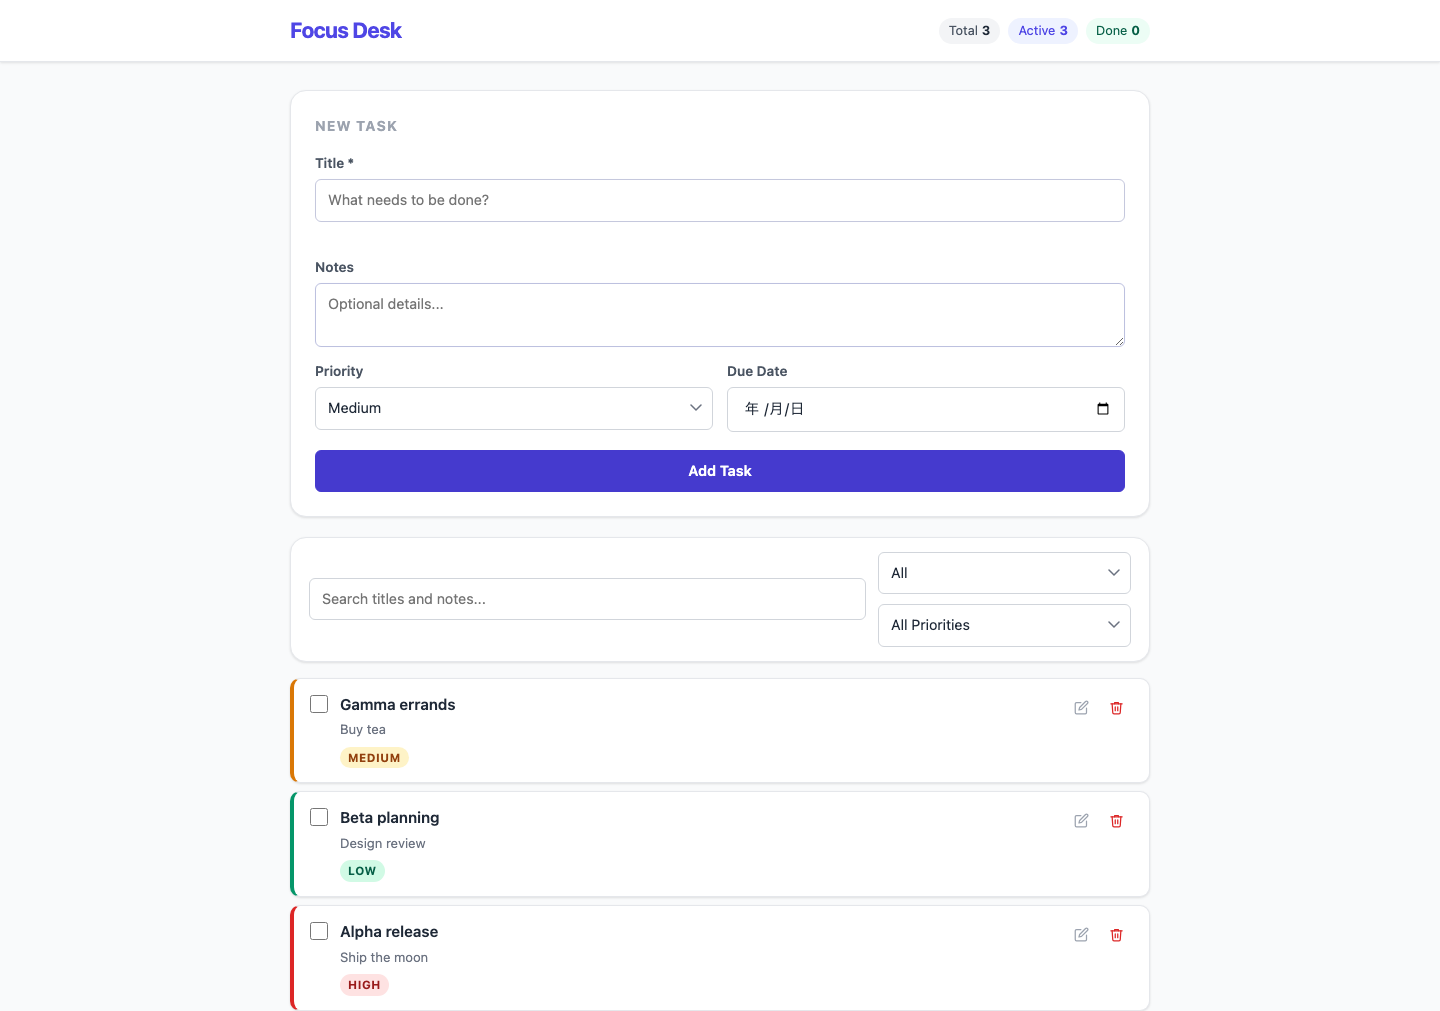
0.15円+未確定 / 196.12秒 / 3/20
API生成エラー
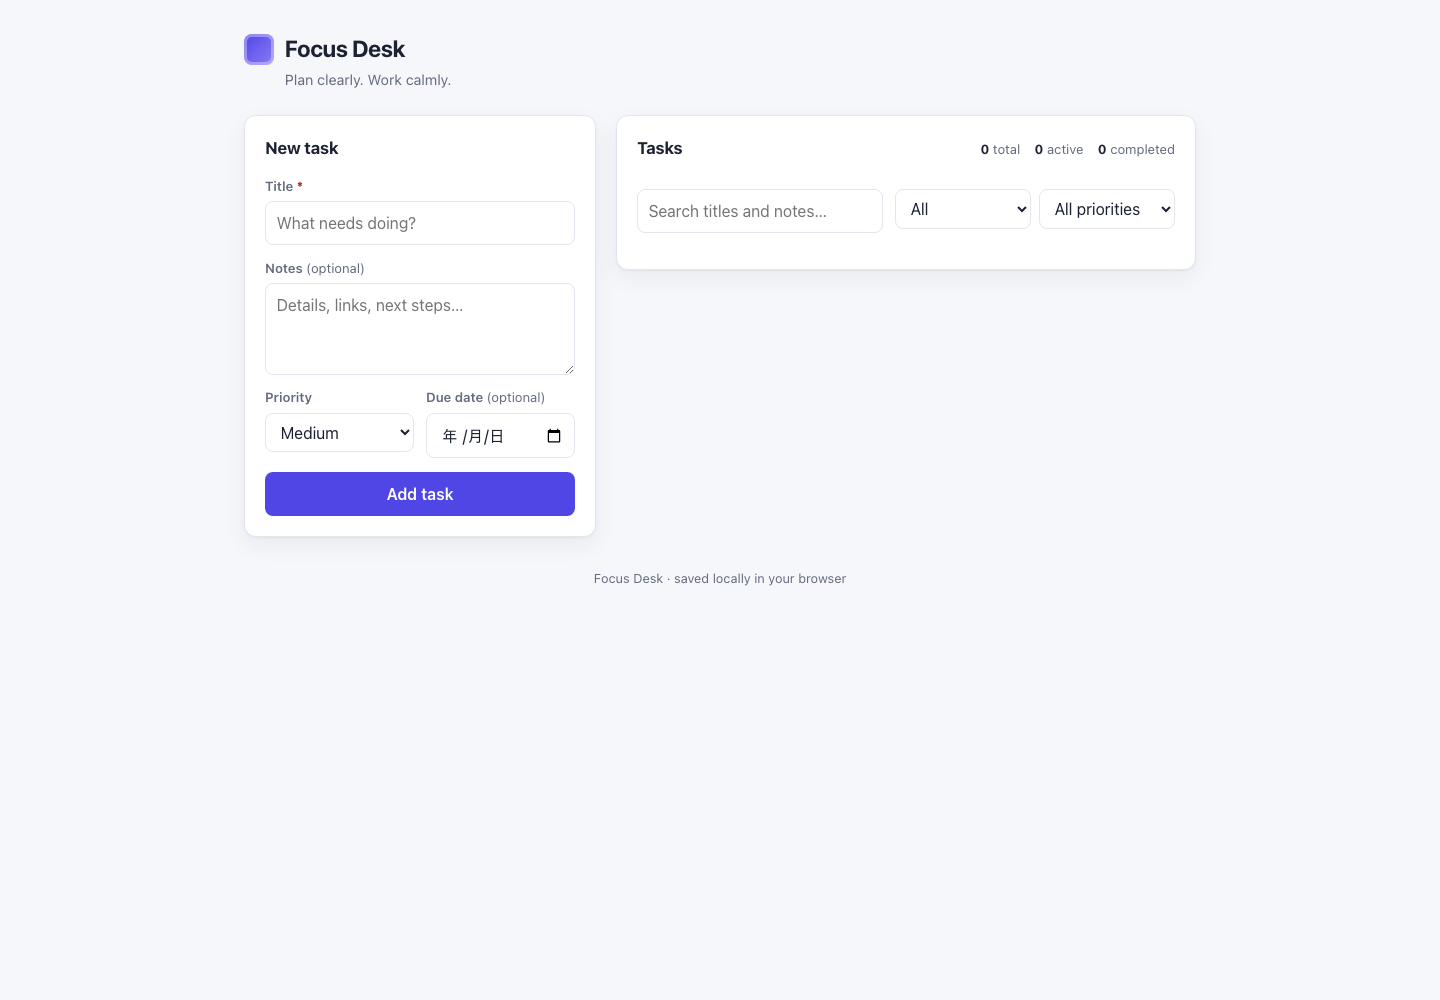
16.27円 / 279.57秒 / 20/20
正常終了
2.14円 / 39.35秒 / 20/20
正常終了
17.60円 / 41.91秒 / 17/20
正常終了
108.40円 / 126.02秒 / 20/20
費用予約枠で停止
26.66円 / 142.36秒 / 3/20
正常終了
173.11円 / 408.36秒 / 20/20
正常終了
実CLIログを並べた録画です。個々のUI操作を比べるフルTUI録画ではありません。